
tinker-voice-clone
基于 audio.cpp(通过 audiocpp-static)的本地音色克隆插件。
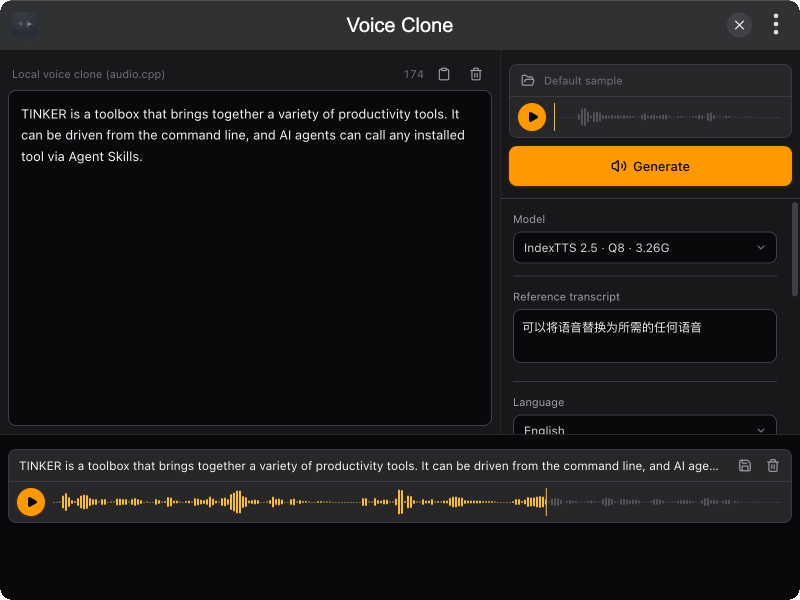
功能特性
- 本地音色克隆:支持 IndexTTS / VoxCPM2 / OmniVoice / Qwen3-TTS GGUF 模型
- 参考音频:可使用默认样例,或在支持的模型中使用音色设计文本
- 自动下载模型:缺失时通过 Downloader 下载到
~/.tinker/models/ - 生成队列:支持 WaveSurfer 预览、播放和保存为 WAV
- 本地推理 后端:Metal / CPU / CUDA / Vulkan
安装
下载并安装 TINKER,然后运行:
bash
npm i -g tinker-voice-clone使用方法
- 在选项面板中选择模型、语言和后端
- 保留默认样例,或选择一段短参考 WAV(建议 1–60 秒)
- 输入文本并点击 生成 — 缺失的模型会自动开始下载
- 在音频列表中预览队列结果;就绪后可保存为 WAV
运行时数据位于 ~/.tinker/tinker-voice-clone/(日志 / 输出)。模型共享存放在 ~/.tinker/models/。